Big Data — Caderno de Erros
Matéria: Big Data | Bancas: CESPE, FCC, VUNESP
|
Como usar este caderno: cada seção concentra conceitos que geraram erros em questões de prova.
Admonitions |
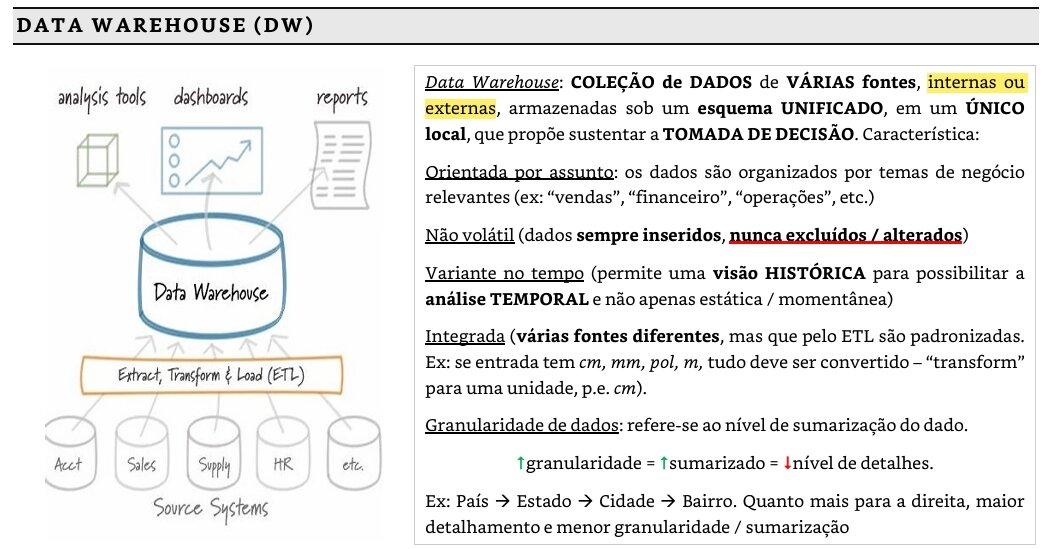
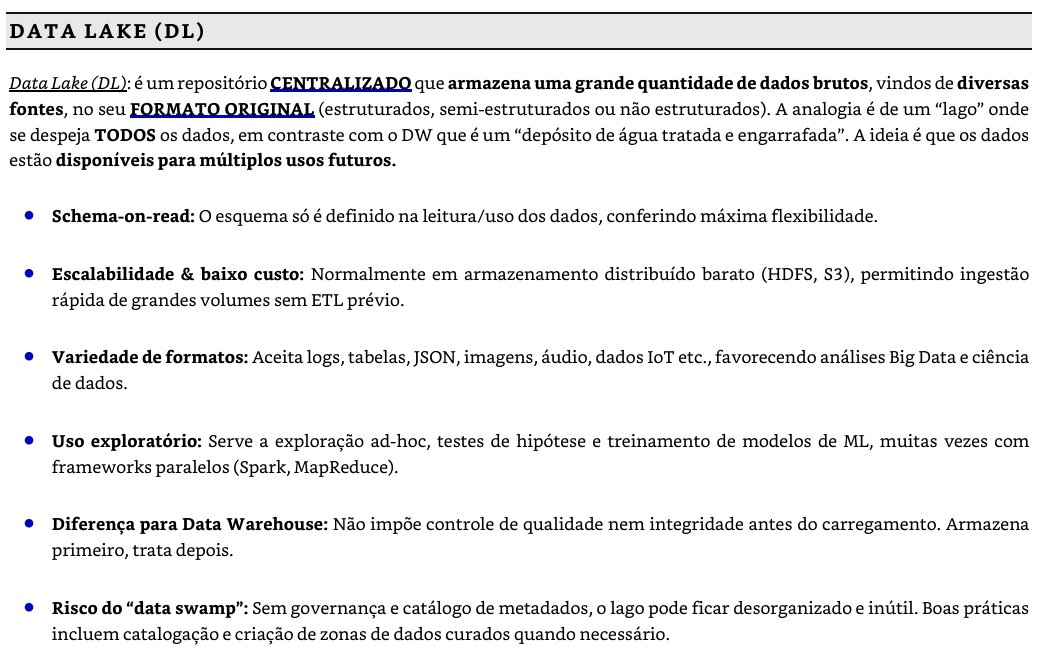
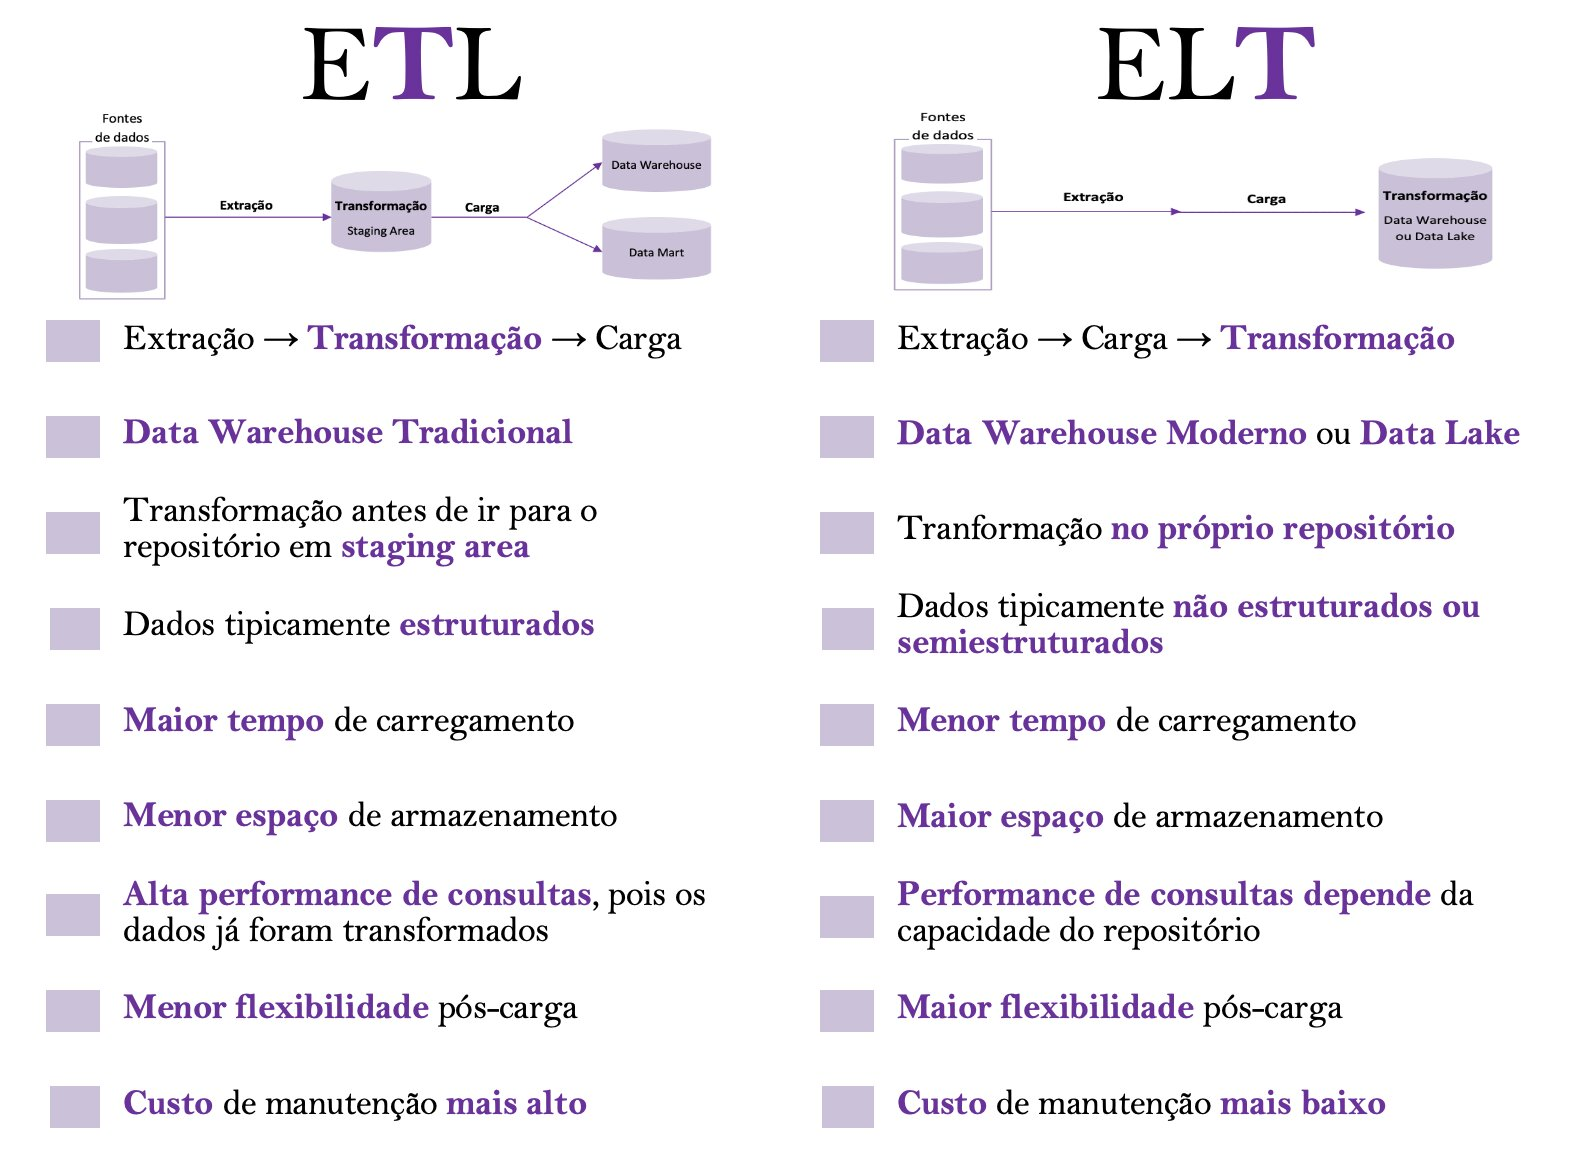
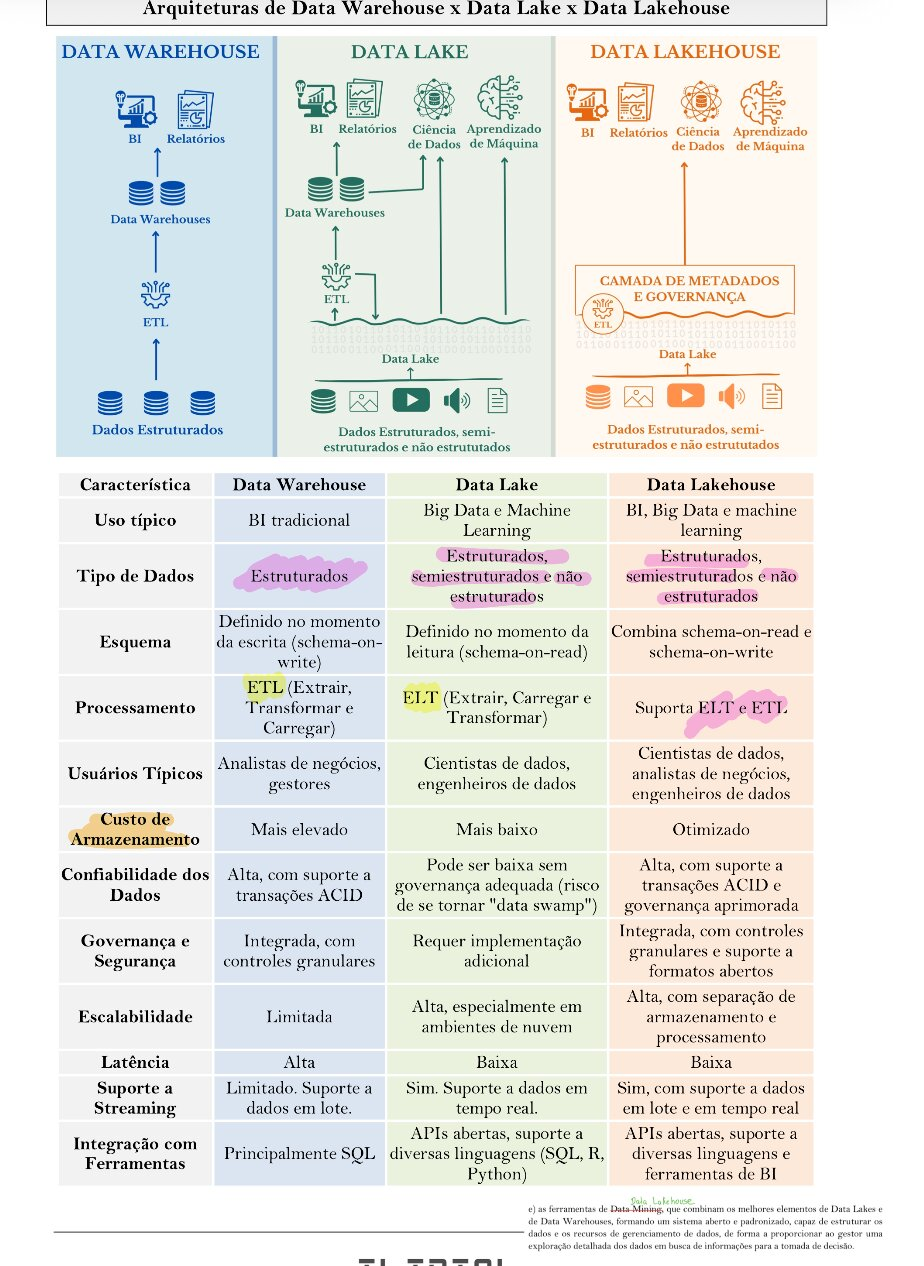
ETL vs ELT
|
ETL consome menos espaço que o ELT. ELT é mais rápido do que o ETL. |
|
ETL = transforma antes de carregar (transformação fora do destino, menor volume no destino). |
Data Lake vs Data Swamp
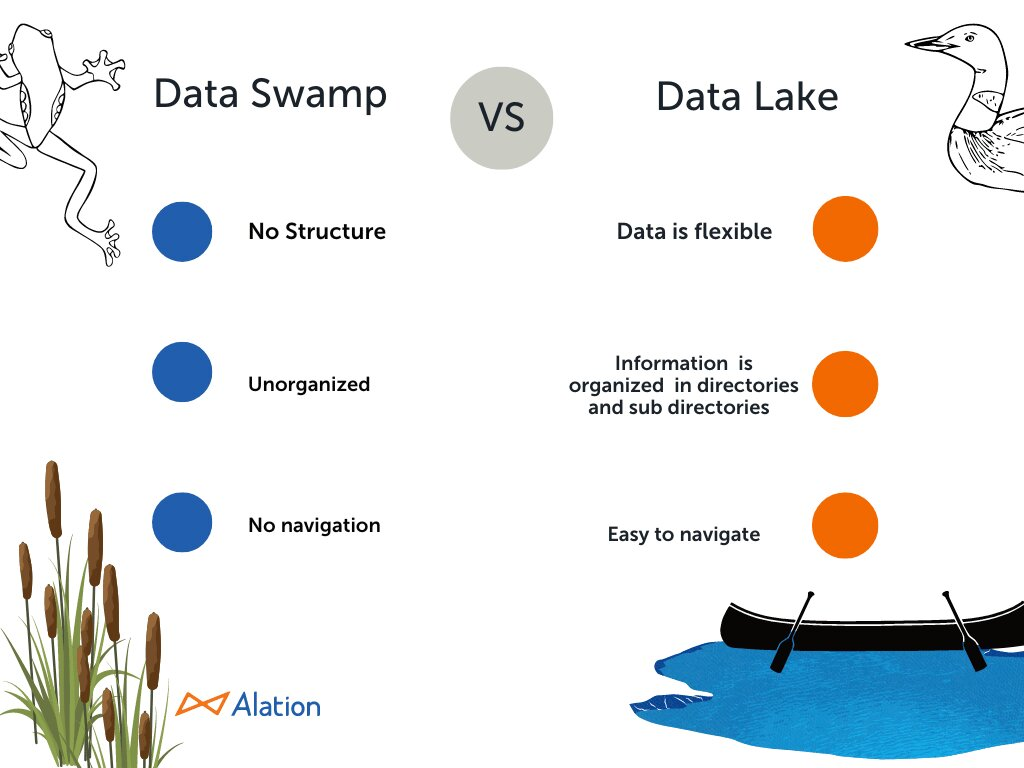
Um Data Lake se transforma em um Data Swamp quando o foco é colocado apenas na ingestão (colocar dados para dentro) e se negligencia a curadoria (organizar e limpar).
Lake |
Lago — calmo, harmonioso, organizado, com visibilidade. |
|---|---|
Swamp |
Pântano — turvo, desordenado, de difícil visibilidade. |
Arquitetura em Camadas — Bronze, Prata, Ouro
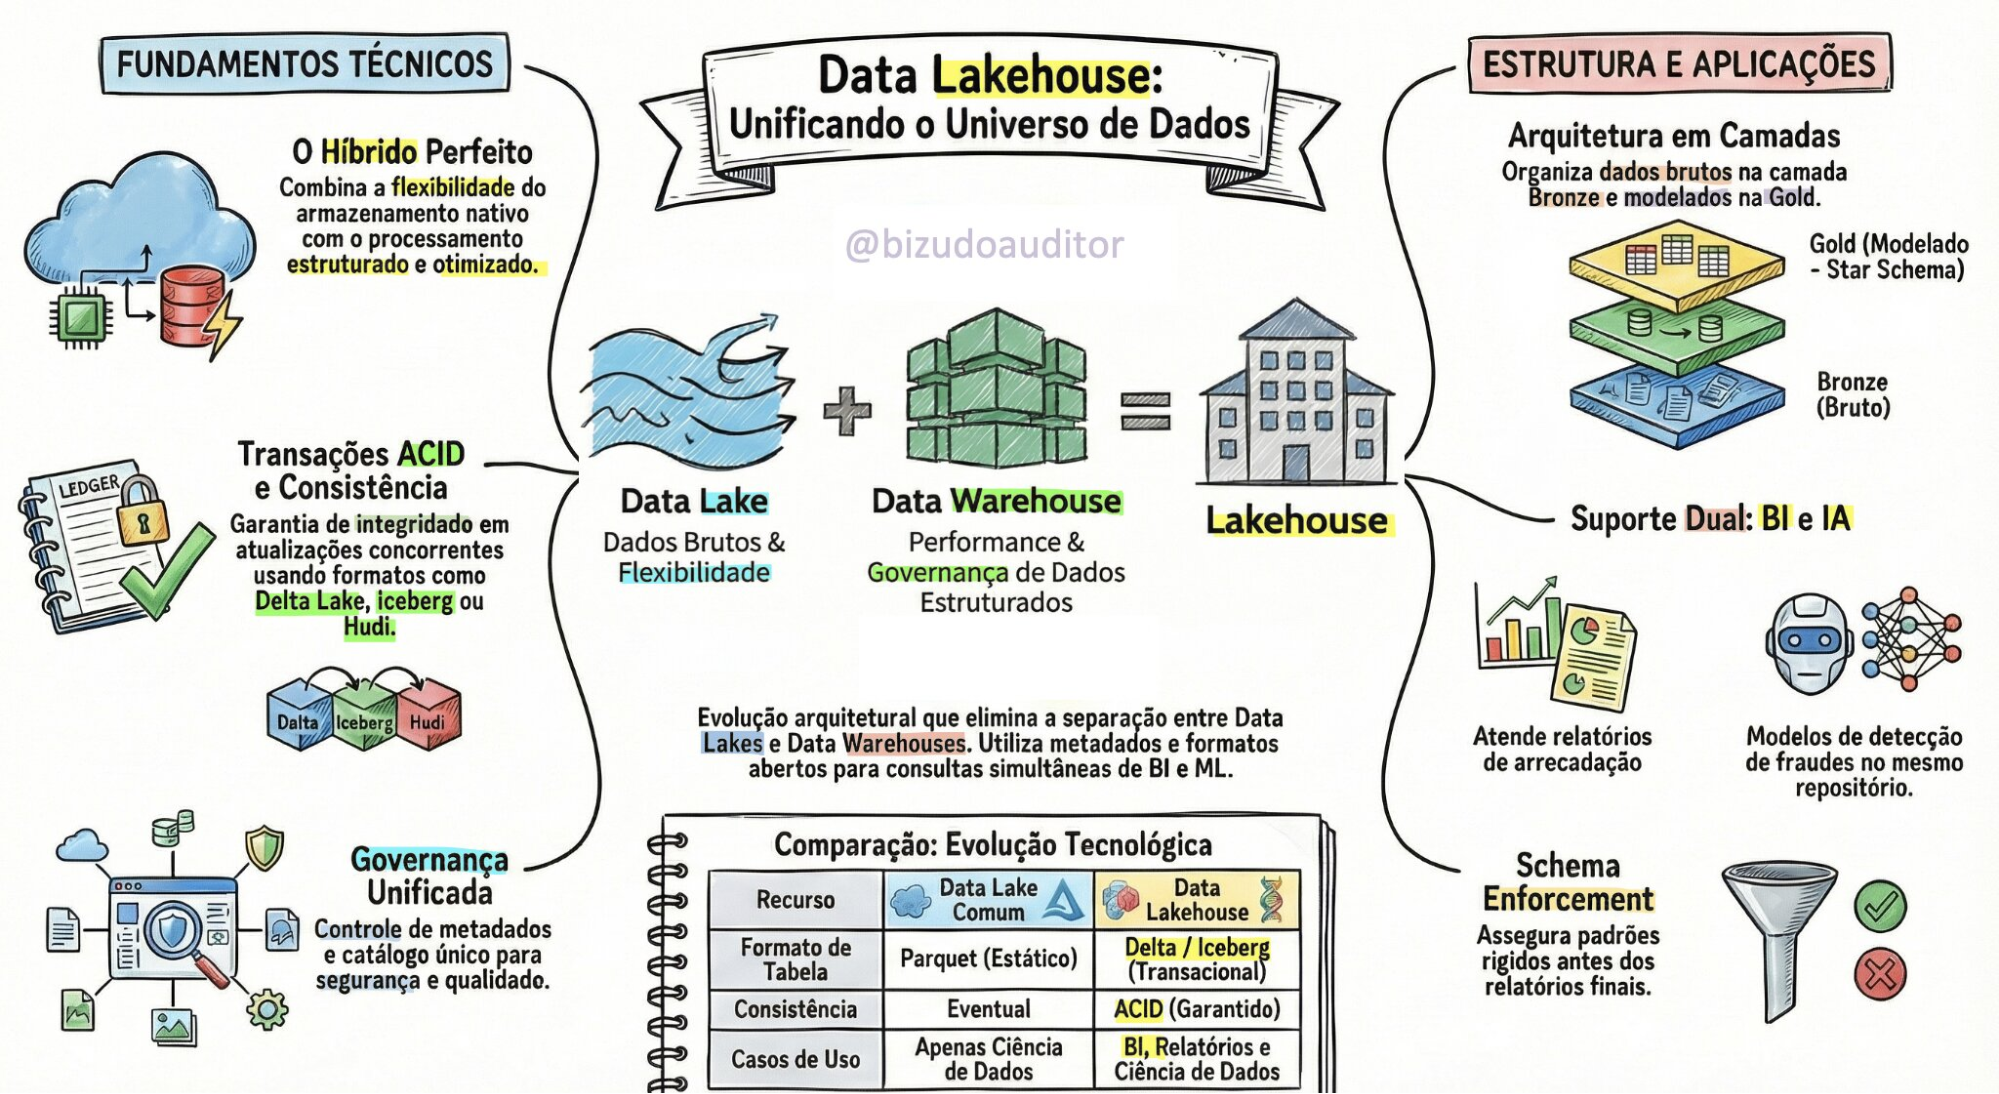
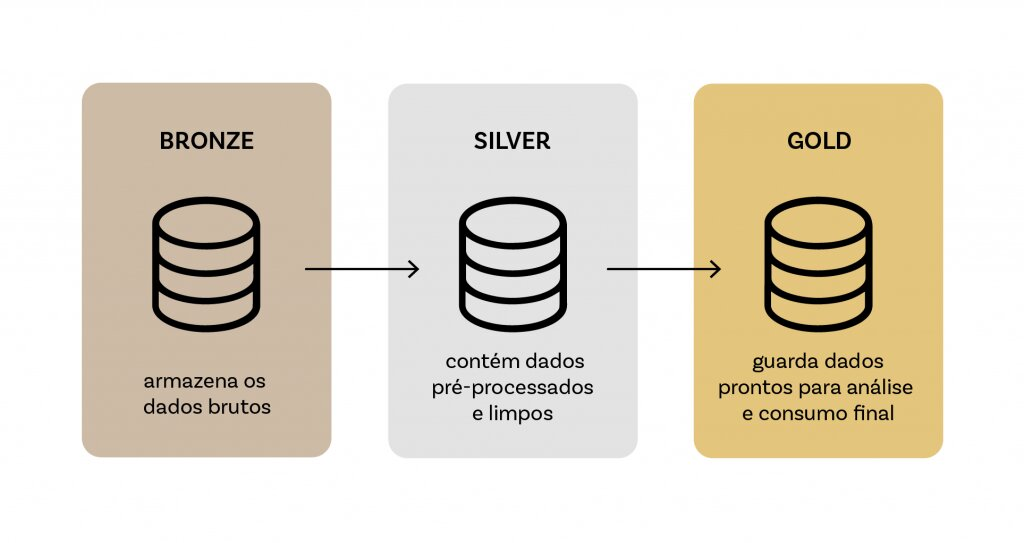
| Camada | Valor | Dados |
|---|---|---|
*BR*onze |
Menos valioso |
Dados *BR*utos — sem processamento. |
*PR*ata |
Valor intermediário |
Dados *PR*ocessados/validados. |
|
Mnemônico: a primeira letra dupla da camada repete a inicial do tipo de dado. *BR*onze = *BR*uto. *PR*ata = *PR*ocessado. |
Data Mesh e Data Product
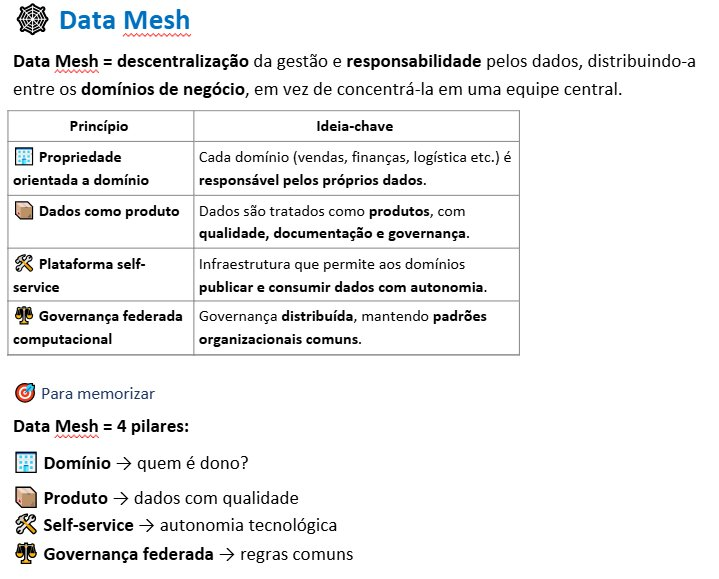
Em uma arquitetura de Data Mesh, para que um produto de dados seja eficaz e autossuficiente (sem necessidade de intervenção humana direta do produtor para cada consumo), ele deve ser autodescritivo e descoberto (discoverable). Isso implica obrigatoriamente que ele exponha metadados (como esquema, semântica, linhagem e SLOs) e seja registrado em um catálogo unificado para que consumidores possam encontrá-lo e entender como usá-lo.
Características de um Data Product (DATSIS)
As características fundamentais de um Data Product no Data Mesh (frequentemente resumidas pelo acrônimo DATSIS ou similar) incluem ser:
-
Discoverable (Detectável): deve estar registrado em um catálogo de dados para ser encontrado.
-
Addressable (Endereçável): deve ter um identificador único ou ponto de acesso programático.
-
Trustworthy (Confiável): deve ter garantias de qualidade e SLOs.
-
Self-describing (Autodescritivo): deve conter metadados claros e documentação estrutural.
-
Interoperable (Interoperável): deve seguir padrões globais para permitir a correlação com outros domínios.
-
Secure (Seguro): deve implementar controles de acesso.
Glossário e Conceitos Complementares
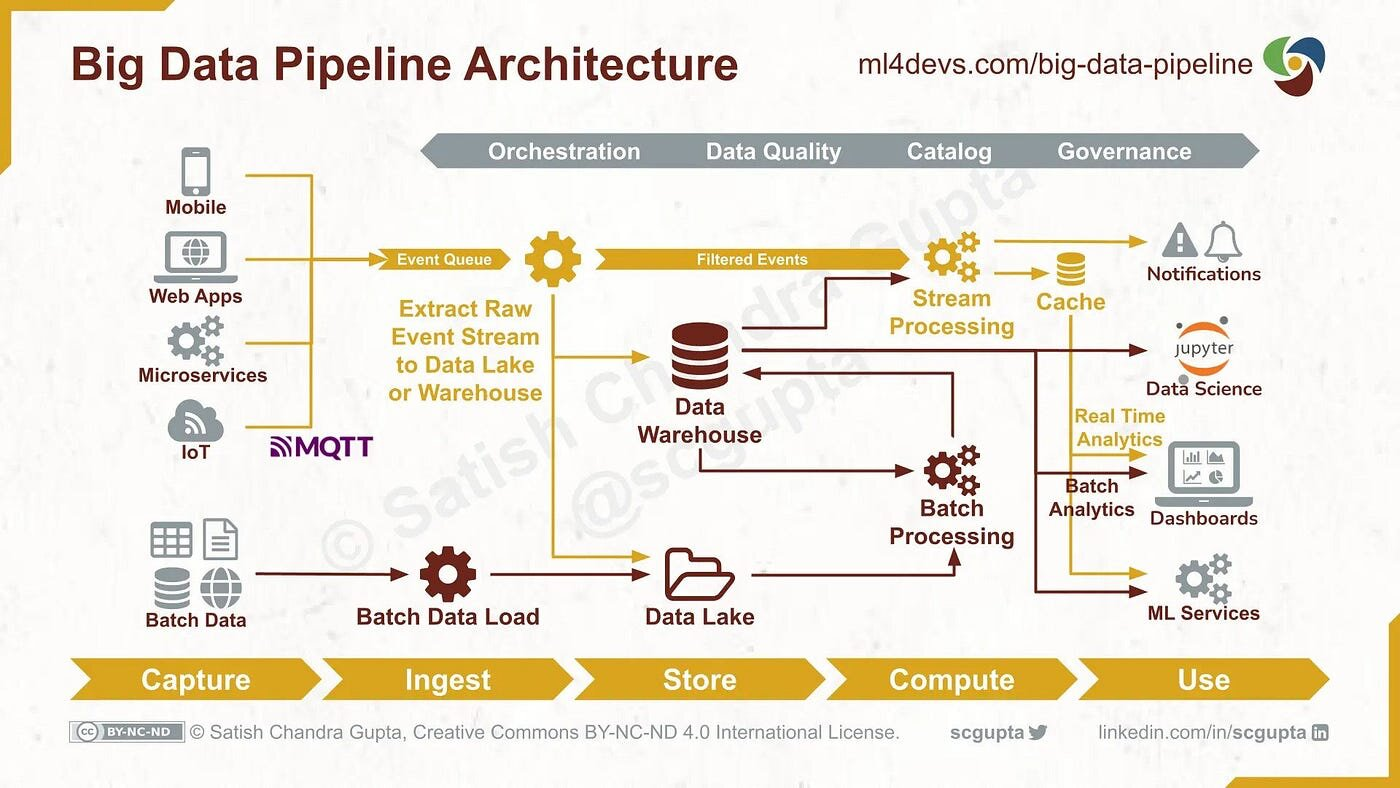
Outras definições:
-
Linhagem de Dados (Data Lineage): o histórico do caminho do dado, mostrando de onde ele veio, quais transformações sofreu e por onde passou até chegar ao repositório.
-
Data Silo (Silo de Dados): informações que ficam isoladas dentro de um único departamento e não são compartilhadas com o restante da empresa.
-
Dark Data (Dados Obscuros): dados que a empresa coleta e armazena na rotina, mas nunca analisa nem utiliza para tomar decisões.
Consistência Distribuída — CAP e BASE
Manter a consistência estrita (ACID) em milhares de nós distribuídos é computacionalmente caro e lento. Por isso, no Big Data, usamos o teorema CAP e o conceito de BASE.
|
BASE = Basically Available, Soft state, Eventual consistency Substitui o ACID no contexto de sistemas distribuídos de grande escala, priorizando disponibilidade e tolerância a partições em vez de consistência imediata. |
BI vs Big Data Analytics
Business Intelligence |
Trata de encontrar respostas que explicam o passado. |
|---|---|
Big Data Analytics |
Trata de encontrar as perguntas que explicam o futuro. |
Técnicas de Amostragem em Big Data
| Técnica | Vantagem | Risco em Big Data |
|---|---|---|
Amostragem Simples |
Rapidez e simplicidade. |
Perda de eventos raros e viés de sub-representação. |
Amostragem Estratificada |
Representatividade de grupos. |
Maior custo de processamento para definir estratos. |
Processamento Full |
Precisão total e detecção de anomalias. |
Alto custo computacional e tempo. |
|
Em Big Data, Amostragem Simples pode invisibilizar eventos raros — exatamente os mais relevantes para detecção de fraudes, anomalias e outliers. |