ITIL 4 — Caderno de Erros
Matéria: Governança de TI | Bancas: CESPE, FCC, VUNESP
|
Apostila base: ITIL 4 — Apostila Completa Como usar este caderno: cada seção concentra conceitos que geraram erros em questões de prova.
Admonitions |
Gestão de Mudanças
Tipos de Mudança
| Tipo | Risco | Autorização | Exemplo |
|---|---|---|---|
Padrão (Standard) |
Baixo / Conhecido |
Pré-autorizada (Procedimento) |
Mudança de senha, regra de firewall validada. |
Normal |
Variável |
Necessita de avaliação (CAB ou autoridade delegada) |
Upgrade de sistema core, migração de datacenter. |
Emergencial |
Alto (Urgente) |
Autoridade de emergência (ECAB) |
Correção de falha de segurança crítica em produção. |
Mudança Padrão (Standard Change) — Ponto Chave
|
Mudanças de baixo risco, pré-autorizadas que seguem procedimento estabelecido. Ao validar regras de firewall em homologação com testes automatizados, a equipe garante que a regra é segura antes de ir para produção — permitindo execução rápida e repetitiva sem novas aprovações burocráticas. |
Validação Contínua: automação que simula produção é o coração da validação contínua, permitindo infraestrutura como código (IaC) e mantendo estabilidade dos serviços críticos.
Métricas de Disponibilidade
Fórmula Central
|
Disponibilidade = habilidade de um serviço de desempenhar sua função acordada quando necessário. Disponibilidade = MTBF / (MTBF + MTRS) MTBF (Mean Time Between Failures): tempo em que sistema funciona até próxima queda. Maior = melhor. MTRS (Mean Time to Restore Service): tempo desde a queda até o serviço voltar. Menor = melhor. Disponibilidade cai quando MTRS aumenta — mesmo que o sistema não quebre mais vezes do que antes. |
Cadeia Completa de Métricas
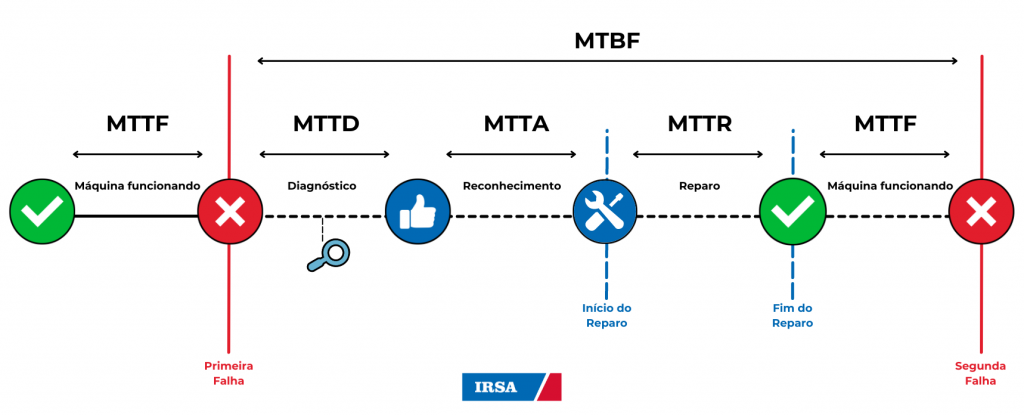
| Métrica | O que mede | Foco |
|---|---|---|
MTTF |
Confiabilidade de componentes não reparáveis (descarte após falha) |
Hardware descartável: cabo, SSD queimado |
MTBF |
Confiabilidade de componentes reparáveis |
Sistemas em geral |
MTTD |
Tempo entre falha ocorrer e TI detectar |
Qualidade do monitoramento (Zabbix, Grafana) |
MTTA |
Tempo entre alerta e analista assumir |
Velocidade de triagem / eficiência do Service Desk |
MTTR |
Tempo de reparo efetivo (diagnóstico, correção, teste) |
Habilidade técnica da equipe |
MTRS |
MTTD + MTTA + MTTR |
Tempo total de restauração do serviço |
|
TI madura: aumentar MTTF (maior robustez) + reduzir MTTD, MTTA e MTTR (resposta rápida a falhas). Resumo prático para prova: Aumentar MTBF e reduzir MTRS. |
Gerenciamento de Incidentes
Incidente = interrupção não planejada ou redução na qualidade de um serviço de TI.
Matriz de Priorização
Prioridade = Urgência × Impacto.
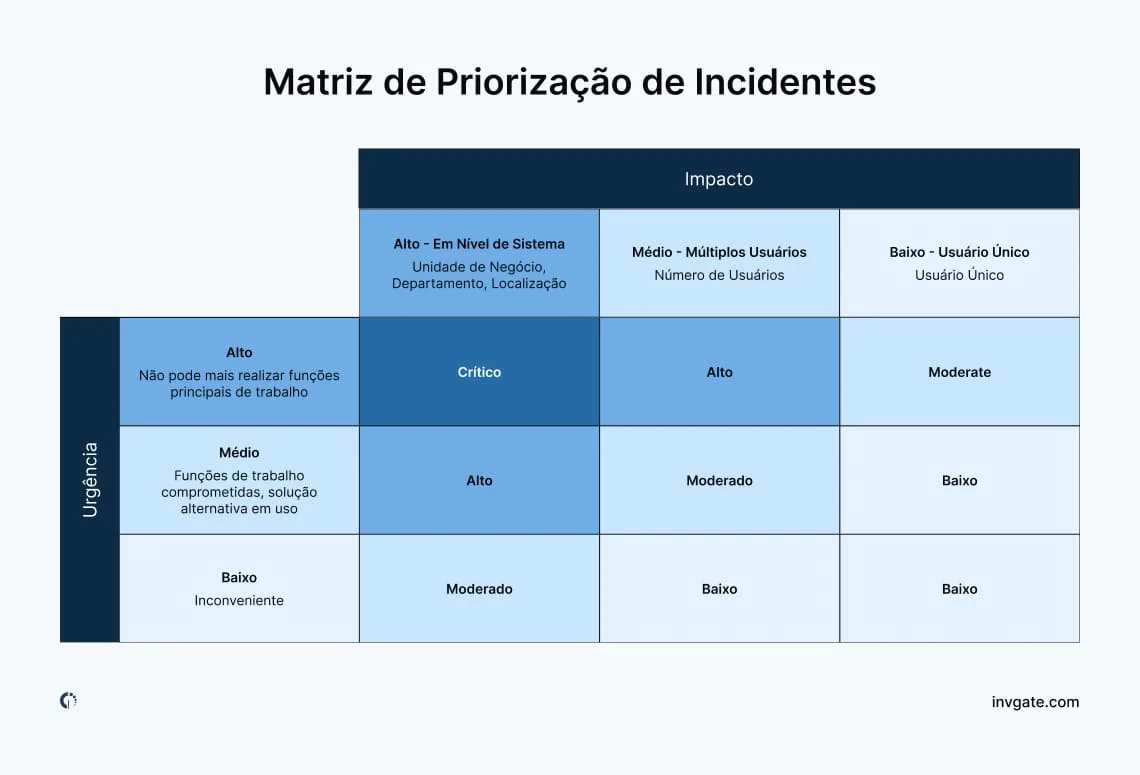
| Urgência \ Impacto | Alto (Sistema) | Médio (Múltiplos usuários) | Baixo (Usuário único) |
|---|---|---|---|
Alto |
Crítico |
Alto |
Moderado |
Médio |
Alto |
Moderado |
Baixo |
Baixo |
Moderado |
Baixo |
Baixo |
|
Urgência = velocidade com que o negócio precisa da resolução. Não confundir: alta urgência não implica necessariamente alto impacto. |
Gerenciamento de Problemas
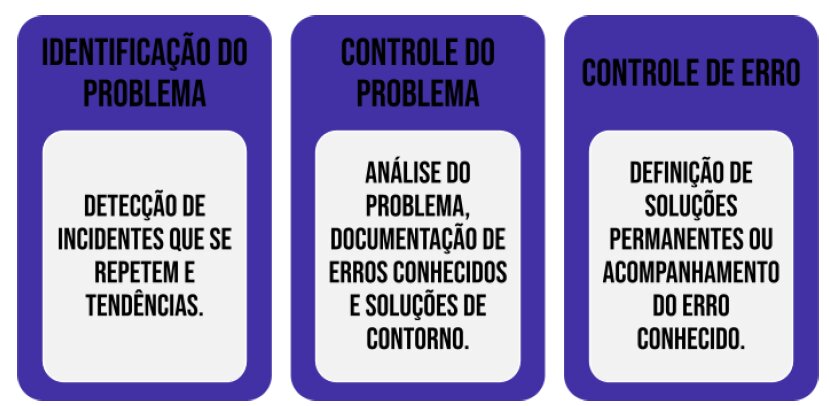
Problema = causa raiz de um ou mais incidentes.
|
A pergunta errada: "o que causou o incidente?" (resposta superficial: arquivo de configuração reescrito). Gerenciamento de Problemas identifica e elimina a causa raiz, não apenas o sintoma. |
Escopo vai além de TI isolada: deve ser praticado em amplitude com desenvolvedores, segurança e software. Processo fragmentado em silos não tem valor para a empresa.
Gerenciamento de Configuração e CMDB
O que é e o que não é
|
CMDB (Configuration Management Database) = banco central de Itens de Configuração (ICs) relevantes para entrega de serviços. ICs: qualquer componente que precisa ser gerenciado para oferecer um serviço de TI — roteadores, servidores, aplicativos, máquinas virtuais. Não é um banco de dados de operações de negócio. Escopo deve priorizar ICs críticos ao fluxo de valor, não abranger tudo indiscriminadamente. |
CMDB e Gerenciamento de Implantação/Liberação
Capacidade do CMDB: avaliar riscos com base em dependências reais (letra B nas questões).
Benefício prático para implantação/liberação: reduzir falhas pós-implementação (letra A nas questões).
|
A banca foca no efeito final, não na capacidade técnica. |
IA e Validação de Serviços
No ciclo de vida de sistemas de IA, processar dados (preparação de base de treinamento e teste) alinha-se ao:
Gerenciamento de Validação e Testes de Serviço — garante que:
-
Dados utilizados sejam consistentes e adequados
-
Sistema seja validado antes de entrar em produção
-
Resultados atendam aos requisitos de qualidade e confiabilidade
Distrações da banca
Prática |
Por que não é a resposta aqui |
Liberação |
Trata entrega de versões de serviços/componentes |
Gerenciamento de Incidentes |
Trata resolução de falhas e interrupções |
Gerenciamento de Disponibilidade |
Foca em manter serviços acessíveis e operacionais |
Catálogo de Serviços |
Organiza e disponibiliza informações sobre serviços |
Princípios Orientadores
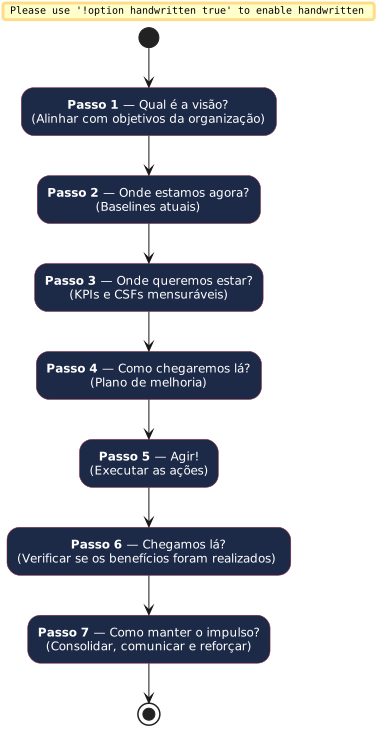
São 7 princípios que guiam decisões e ações no ITIL 4 — aplicáveis a qualquer situação.
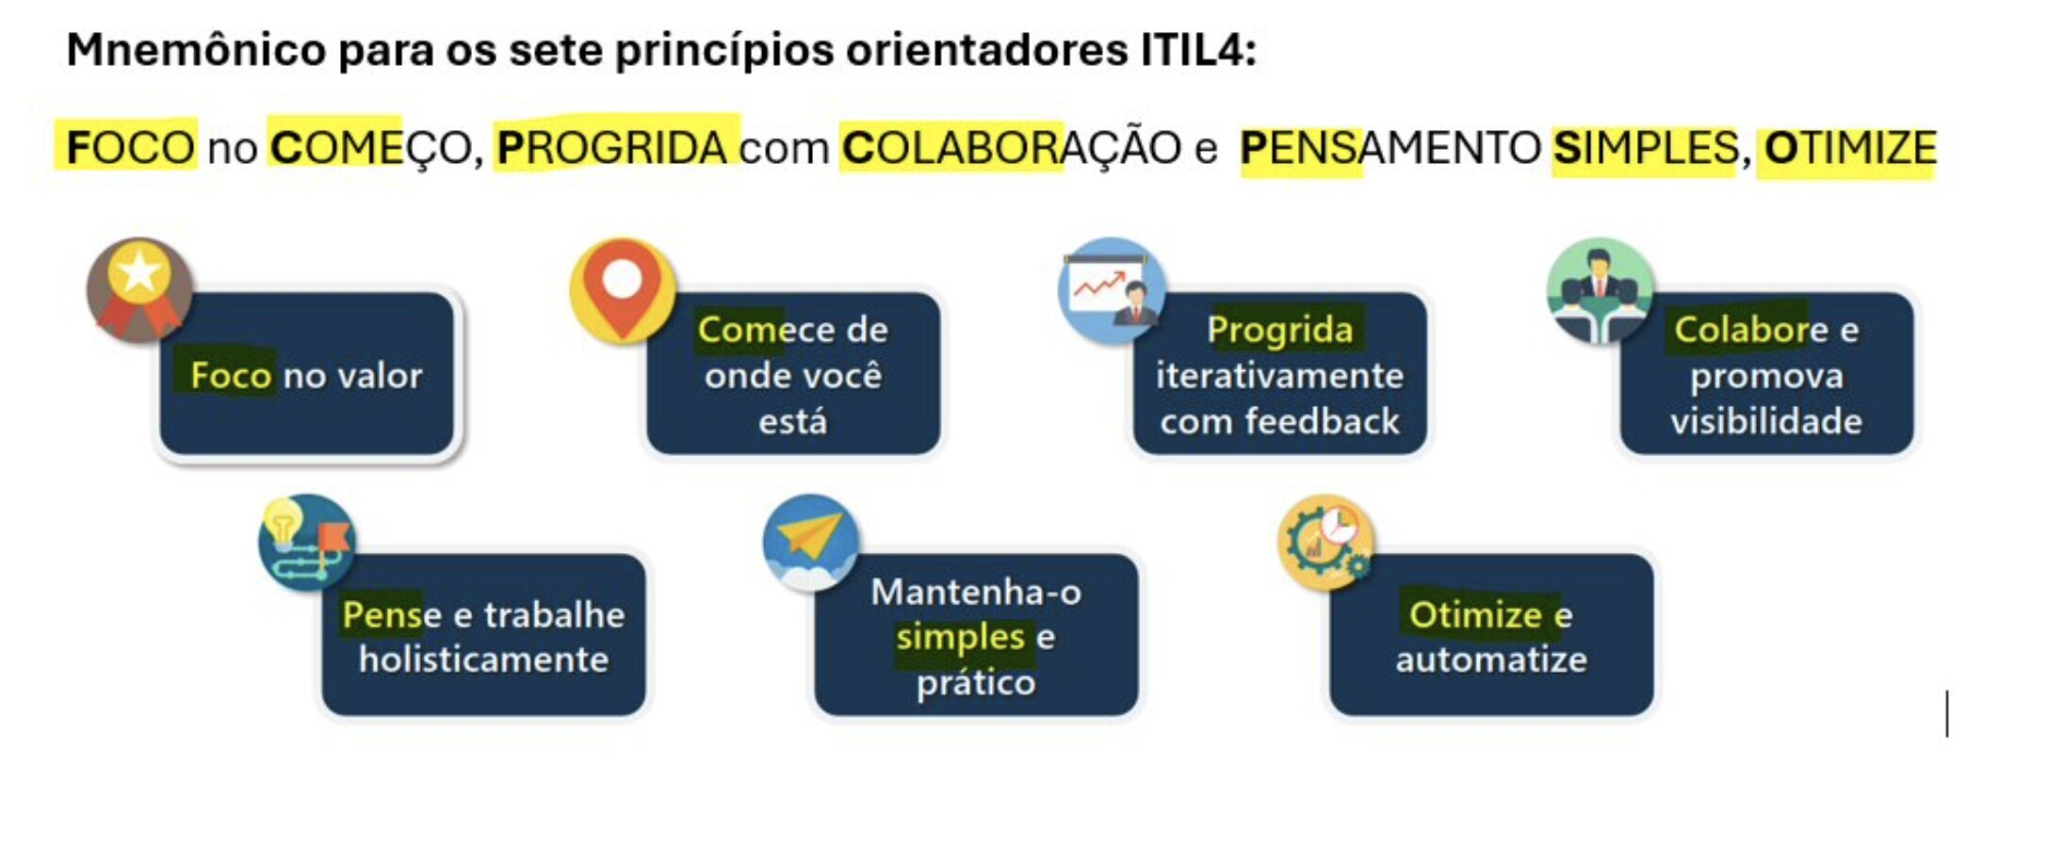
| Princípio | Descrição | Palavra-chave |
|---|---|---|
Foco no valor |
Todo trabalho deve criar valor para os stakeholders |
Valor |
Comece de onde você está |
Aproveite o que já funciona. Não reinvente sem avaliar |
Reaproveitamento |
Progrida iterativamente com feedback |
Pequenas entregas + feedback contínuo + melhoria |
Iteração |
Colabore e promova visibilidade |
Trabalho em conjunto com transparência |
Colaboração |
Pense e trabalhe holisticamente |
Visão sistêmica — nada funciona isolado |
Holismo |
Mantenha-o simples e prático |
Elimine o que não gera valor |
Simplicidade |
Otimize e automatize |
Use tecnologia para liberar trabalho humano criativo. |
Automação |
|
Automação de um processo ineficiente só gera um erro mais rápido. A inovação tecnológica não agrega valor por si só. Otimizar primeiro (limpar o processo) para depois automatizar. |
Service Desk
|
No ITIL v4, o Service Desk não atua apenas de forma reativa. Além de ser ponto único de contato para incidentes, também desempenha atividades proativas:
|